
推荐书籍 007|Redis 设计与实现
这本书让我从 Redis 命令走向数据结构、事件循环、持久化与多机协作的内部原理,理解性能和内存之间的取舍,也成为需要深入某个功能时可以反复查阅的参考书。
《Redis设计与实现》封面
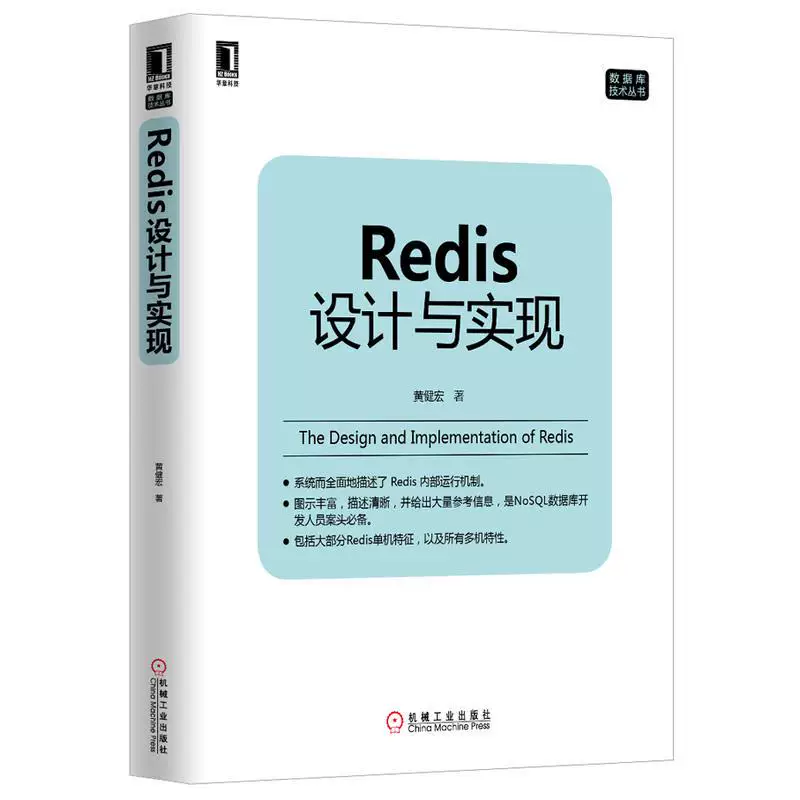
《Redis 设计与实现》让我对 Redis 的认识,从日常使用的命令,进一步深入到它背后的数据结构、执行模型和运行机制。
如果已经使用过 Redis,希望理解它为什么这样设计、什么情况下会遇到性能或可靠性边界,我觉得这本书很值得读。尤其是数据结构的取舍和事件循环,让许多原本零散的知识有了联系。
先说明版本:书中分析的是 Redis 2.9,也就是当时 Redis 3.0 的开发版。它适合帮助理解设计思路,具体编码、线程模型和持久化细节,需要再结合正在使用的版本核对。内容与版本说明可以在作者的读者服务网站查阅。
一、这本书主要讲什么
首先是 Redis 内部的数据结构与对象。我们平时接触字符串、列表、哈希、集合和有序集合时,看到的是它们提供的功能与命令;书中继续向下解释这些功能依靠什么结构实现,以及对象类型与底层编码怎样配合。
对我来说,这部分很有帮助。一个对外类型,并不一定永远使用同一种底层组织方式。数据量、元素内容和操作需求不同,适合的实现也可能不同。理解这一点,再看 Redis 怎样考虑性能和内存,就更容易理解它的设计。
然后是单机数据库的运行。键与过期时间怎样管理,客户端请求怎样进入服务器,事件怎样被处理,以及 RDB 和 AOF 怎样保存、恢复数据,能够逐渐连成一个完整过程。
多机部分则把复制、Sentinel 和 Cluster 放进各自的位置:复制把数据传播到副本;Sentinel 面向主从部署进行监控和故障转移;Cluster 在多个节点间分配数据,并提供相应的故障处理机制。它们解决的问题有关联,也有不同的职责。
书中还讨论事务、发布订阅、Lua 脚本、慢查询日志等功能。不过,我更看重的是它怎样把数据结构、命令执行、持久化和多机协作放在一起,让我们理解一个实际系统怎样运转。
二、最大的启发:性能来自具体取舍,事件循环也有边界
数据结构部分让我印象很深的一点,是 Redis 并没有简单地为每种类型固定一套实现,然后只追求某一个指标。很多设计需要同时考虑查找、更新、遍历和内存占用。
例如,元素较少时,紧凑存放可能节省额外的指针和管理开销;当元素更多、访问需求改变时,又可能需要其他组织方式。节省空间往往也会影响某些操作需要完成的工作。读这些设计时,我更愿意关注它在什么条件下做了什么交换,以及这样的交换是否符合使用场景。
这种认识也能用于日常开发。选择数据结构时,需要一起考虑数据规模、操作方式与资源约束。只记住一个时间复杂度,或者只比较某次测试的内存数字,还不足以解释完整的工程选择。
另一个特别重要的启发,是 Redis 的事件循环。
借助 I/O 多路复用,事件循环可以关注许多连接的可读、可写状态,再处理相应的事件。配合非阻塞网络 I/O,就不必为每个连接都安排一条线程,在等待某个客户端的数据时,也能继续照顾其他连接。
这让我更具体地理解了:服务大量连接,并不要求同一时刻并行执行同样数量的命令。连接可以同时存在,请求可以陆续就绪,而核心命令执行路径上的工作仍然可以逐个完成。只要大多数工作足够短,就能比较快地继续处理其他请求。
当然,Redis 的性能还与内存访问、高效的数据结构、协议和实现方式等因素有关,不能只归结为“用了一个事件循环”。事件循环提供了组织并发 I/O 的方式,处理每项工作的成本仍然需要控制。
这里与 Python asyncio 有一个很值得联系起来理解的地方:承担事件处理的执行线程,如果长期被一项任务占住,其他就绪任务就可能继续等待。
在 Redis 中,扫描大量数据的命令、处理巨大结果或运行过久的脚本,都可能占用较长的执行时间。哪怕其他客户端只是发出简单请求,也可能需要等前面的工作结束。具体影响可以结合官方延迟排查说明继续理解。
因此,理解事件循环时,我会特别关注:怎样避免让耗时工作长期占据核心事件处理路径,以及怎样控制单次操作处理的数据规模。某个操作究竟影响多少,仍然要结合实际版本、实现路径和测量结果判断。
这个类比也有边界。Redis 的事件处理不等于 Python 的协程调度;BLPOP 等命令让客户端等待,也不意味着服务器线程一直停在那里等待这个客户端。需要分清等待的是谁,以及执行资源是否真的被占住。
三、对实际使用和排查问题有什么帮助
理解底层以后,使用 Redis 时就更容易提出具体的问题。
遇到内存增长,可以继续看数据模型、键和元素的数量、底层编码与对象开销;遇到延迟升高,可以把命令处理的数据规模、网络传输、持久化和系统资源等因素分别检查。知道实现原理,能帮助确定观察方向,再用实际指标寻找证据。
持久化部分尤其值得反复看。RDB 保存某个时点的数据快照,AOF 记录数据变更,并通过相应的写入、刷盘和重写机制管理持久化内容。理解这些过程以后,再比较恢复、磁盘开销、运行开销和可能的数据丢失窗口,就更容易看清各项配置的含义。
例如,开启 AOF 并不等于每次变更都立即完成磁盘同步;采用后台任务,也不意味着主请求路径一定完全没有延迟或内存影响。配置需要放到整个运行过程里理解,当前机制可以继续核对官方持久化文档。
复制与高可用同样如此。建立副本、发现故障、选择新的主节点、让客户端切换连接,是相关但不同的环节。异步复制和自动故障转移,也不能直接推导出任何故障下都不会丢失已经确认的写入。
书中的这些内容让我更容易理解系统为什么需要这些步骤,以及某个功能能够承担哪一部分责任。这样在做选型、配置或排查时,才有基础继续讨论自己的数据和业务需要什么。
前面推荐的 C、链接装载和 UNIX 系统编程知识,在这里也能互相印证。数据结构最终需要组织成实际内存中的对象,网络处理需要使用系统接口,持久化还会涉及文件、进程和操作系统行为。带着这些认识阅读,Redis 的内部机制会更具体。
四、我的阅读建议:先建立整体认识,需要时再回到对应章节
我觉得这本书很适合成为一本可以反复翻阅的参考书。第一次阅读,可以先建立数据结构、事件处理、持久化与多机协作之间的关系;以后需要理解某一块,再回到对应章节深入。
比如,想知道一个类型为何有不同编码,可以回到对象与数据结构;想理解某类请求为什么拖慢其他请求,可以回到事件和服务器;需要讨论数据恢复或故障切换时,再看持久化、复制、Sentinel 和 Cluster。
阅读时可以固定问几个问题:它要解决什么问题?内部维护什么状态?关键操作需要处理多少数据?节省了什么资源,又增加了什么成本?这些问题能够帮助我们从“知道功能”继续走向“理解设计”。
涉及具体代码和配置时,再对照实际版本。书中讲到的压缩列表等结构,并不能代表今天所有类型的编码选择;较新的 Redis 还发展了 I/O 线程、多段 AOF 等机制。理解书中的设计以后,再看这些演进,更容易知道它们为什么发生。
同样,不宜把核心命令执行模型概括成“Redis 的所有工作永远只有一个线程”。后台线程、持久化子进程和不同版本的 I/O 处理,需要分别理解。保留清楚的职责划分,比记住一个过度简化的结论更有帮助。
我推荐《Redis 设计与实现》,很重要的原因就是它能够长期陪伴实际开发:需要了解某个功能时,可以重新翻出来,沿着数据结构和执行过程继续理解。读完以后,再看 Redis 的命令、性能和可靠性,背后会多出一层可以解释、也可以验证的认识。
记录过程,也留下判断。
← 继续阅读其他文章