
推荐书籍 006|Python 源码剖析
这本基于 Python 2.5 的书,让我从日常写法走向 CPython 的对象、虚拟机、GIL、模块加载与内存管理,也为进一步学习性能分析、探索性能分析平台的 runtime 能力打下基础。
《Python源码剖析》封面
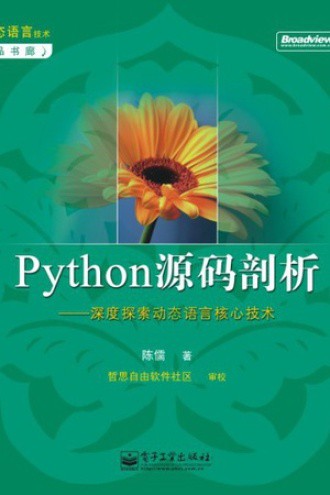
《Python 源码剖析》是一本让我对 Python 底层运行原理有了更深入认识的书。它帮助我从“知道这段代码怎么写”,进一步走向“理解解释器怎样执行这段代码”。
先说明版本:陈儒这本书分析的是 Python 2.5 的 CPython 实现。许多具体结构和接口已经变化,但对于已经会使用 Python、希望继续理解对象、虚拟机、并发和内存管理的开发者,它仍然提供了一条很有价值的学习路径。阅读时需要把原理认识与当前版本的实现细节分开。
前面推荐的 C 语言、链接装载和 UNIX 系统编程知识,在这里也能连接起来:Python 解释器本身就是一个程序,它既要组织对象和执行代码,也要使用操作系统提供的能力。
一、这本书主要讲什么
这本书以 CPython 的 C 代码为入口,解释我们日常使用的 Python 功能怎样实现。它讨论的是一种具体解释器,而不是所有 Python 实现都必须采用的内部结构。具体内容可以对照出版社提供的电子书简介与目录。
对象是很重要的起点。整数、字符串、列表、字典等类型,在使用层面非常方便;继续向下看,就会发现它们有各自的数据组织方式、操作逻辑和资源管理规则。“一切皆对象”也因此有了可以观察和理解的实现依据。
虚拟机则把这些对象与代码执行连接起来。代码对象、字节码、执行状态和解释器的求值过程,共同说明程序如何一步步向前运行。函数调用、局部状态和返回,也就能够放进这条执行过程里理解。
模块加载和 C 扩展,让我们看到 Python 与外部代码怎样连接。导入一个模块涉及查找、加载和初始化等工作;扩展模块则让 C 代码通过相应接口与 Python 对象交互。继续理解这些机制,才能知道一个模块为什么能被使用,以及语言之间需要怎样配合。
内存管理与执行并发也是其中的重要部分。对象为什么还活着,引用关系怎样影响释放,循环引用怎样处理,解释器又如何协调多个线程,都与程序真正运行时的行为有关。
我觉得这本书的价值,就在于这些主题能够互相连接。对象提供数据,虚拟机执行操作,模块组织功能,扩展模块连接本地代码,内存和线程机制共同支撑运行,原本分散的知识开始形成一个整体。
二、最大的启发:Python 的方便背后,也有具体的执行过程
学习 Python 时,很容易把注意力放在语法和功能上。读这本书以后,我对底层的认识有了明显变化:简洁的写法背后,仍然有对象、类型、引用关系和一系列执行步骤。
例如,变量与对象的关系,就值得重新理解。给一个名字赋值、把对象放进容器、把参数传给函数,都会形成需要继续分析的引用关系。理解这些关系以后,再看可变对象、共享数据和对象生命周期,就更容易找到具体的解释。
基本类型也不只是几个语法符号。选择列表还是字典,频繁创建临时对象,或者反复转换数据,背后都有相应的工作。源码知识提供了一种思考成本的方式;至于某段业务代码到底花费多少,仍然要放到实际数据和运行环境中测量。
对我来说,虚拟机尤其重要。它让我开始理解,一段代码的运行需要保存哪些状态,函数调用怎样推进,以及执行为什么能够在某些位置停下来、以后再继续。
这也为理解生成器和协程打下了基础。生成器在 yield 处挂起后,后续恢复不能从头再执行一遍,而需要接着之前的执行位置和状态继续。把这件事理解清楚,再看协程的挂起与恢复,就更容易理解它为何能够组织多项任务的交替执行。
不过,这本书不是现代 asyncio 的实现指南。Python 2.5 的生成器机制与后来原生协程的发展有关,但今天的 async/await 是 Python 3.5 引入的,相关背景可以继续阅读 PEP 492。事件循环怎样调度任务、怎样等待非阻塞 I/O,还需要结合对应库继续学习,不能只靠理解虚拟机就把整个异步系统解释完。
GIL 也因此不再只是一个经常听到的名词。在传统启用 GIL 的 CPython 中,线程执行 Python 代码受到解释器锁的协调;I/O 或某些本地扩展又可能释放这把锁。它既不等于“线程完全没有并发价值”,也不替我们保证业务中多个操作组合起来的线程安全。
理解这些机制,对选择并发模型也有帮助。先看任务在计算还是等待,再看具体操作是否受 GIL 限制,才能更有依据地考虑协程、线程或进程,而不是只凭语言标签做决定。
三、对实际开发和 Python profile 有什么帮助
这本书带给我的一个重要变化,是面对程序运行现象时,能够提出更具体的问题。CPU 忙在什么地方?内存是哪些对象占着?某个调用为什么迟迟没有结束?这些现象可能发生在不同层次,需要分别寻找证据。
模块加载就是一个很实际的连接点。导入依赖时,模块的初始化代码可能继续导入其他模块、建立对象或执行其他初始化工作。理解导入过程以后,就更容易分析启动时间和依赖加载带来的内存,而不是只看业务入口里写了多少行代码。
阅读 C 扩展相关代码时,也更容易关注接口边界。Python 对象怎样传入本地函数,结果怎样返回,引用和错误由谁处理,都是需要认真理解的部分。这份认识能够作为继续学习现代扩展开发的基础,具体代码则应以目标 Python 版本的 C API 为准。
内存问题同样需要分层。对象不再需要、引用被释放、解释器回收对象,以及进程内存回到操作系统,并不一定在同一个时刻发生。引用关系、循环垃圾回收和内存分配器共同影响运行结果,不能仅凭容器内存没有立刻下降,就断定一定发生了对象泄漏。当前版本的分配机制,可以继续对照官方内存管理文档。
这也是我计划在 性能分析平台 中继续扩展 runtime 分析的一个知识基础。除了看到进程或容器用了多少 CPU、多少内存,我还希望进一步理解这些资源消耗怎样对应到 Python 的执行过程。这里说的是后续探索方向,并不是这些能力已经全部实现。
我希望后续能逐步把几类问题区分清楚:
- CPU 时间主要消耗在哪些调用路径上,而不是只看到一个使用率数字。
- 请求变慢是在执行计算、等待 I/O,还是受到其他同步条件影响。
- 内存增长与哪些对象分配、引用保留或本地分配有关。
- 线程与协程当时分别在做什么,解释器状态能提供哪些辅助信息。
源码知识可以帮助理解采样结果,却不能替代采样本身。一次栈快照不等于完整因果,Python 对象的分配记录也不等于进程全部内存。把不同证据对应起来,再决定怎样优化,才是我想继续深入的方向。
四、我的阅读建议:用旧版本理解结构,再回到当前版本核对
这本书比较适合已经使用过 Python、并且具备一些 C 基础的读者。能看懂结构体、指针和函数调用,阅读阻力会小很多;理解程序的链接装载、进程和线程,也能帮助看懂解释器与操作系统的连接。
阅读时不必把所有源码一次看完。可以先沿着一个问题走,例如列表怎样保存元素,函数调用需要怎样的执行状态,或者一个模块怎样进入可使用的状态。先建立主线,再回头补细节,通常更容易坚持。
对于书中的具体实现,建议先对照它分析的版本理解,再选择当前使用的 Python 版本进行比较。整数与字符串的类型组织、字典结构、字节码和执行帧等内容都经历过演进,旧字段、旧接口和旧执行路径不能直接当成现代版本的固定答案。
GIL 也要结合运行环境看待。它不是 Python 语言规定所有实现必须拥有的机制;现代 CPython 还提供了可选的 free-threaded 构建。实际是否启用 GIL、扩展模块是否兼容,都需要另外核对,相关说明见官方 free-threading 文档。
我推荐《Python 源码剖析》,主要是因为它让我能够跨过“只会使用语言功能”这一层,继续理解对象、代码执行和资源管理之间的关系。带着这份认识回到实际开发,再去学习性能分析、阅读当前版本源码,很多以前模糊的现象,就有了继续追问和验证的入口。
记录过程,也留下判断。
← 继续阅读其他文章